全球球迷矚目的世界杯決賽即將點燃戰火,這場終極之戰不僅是球員榮譽的最高殿堂,更是大數據科學家進行精準推演的絕佳舞台。隨著兩支頂尖強權突破重圍,闖進最後的世界杯決賽,如何透過科學化的數據模型來解析全場進球數與潛在的戰術走向,成為了社群上最熱門的話題。許多資深足球研究者在進行相關賽事的模擬分析時,不再僅憑直覺與主觀喜好,而是高度仰賴機器學習與統計學模型。透過歷史數據的深度挖掘,我們可以將複雜的球場變化轉化為客觀的機率分布。本文將全面拆解用於決賽預測的核心大數據模型,並針對全場進球數進行多維度的精準推演,帶領讀者從純粹的數據科學視角,深刻感受這場顛峰對決的底層邏輯與魅力。
閱讀更多:距決賽僅一步之遙!FIFA 世界杯四強賽的「高勝率投注策略」與和局鎖利教學
一、終極決賽的數據特徵與歷史趨勢
在四年一度的盛會中,最後的巔峰對戰往往具備與其他淘汰賽截然不同的統計特徵。根據歷史數據顯示,世界杯決賽的常規時間總進球數通常呈現偏低的趨勢。這是因為雙方球隊在經歷了高強度的淘汰賽洗禮後,戰術執行力已達到爐火純青的境界,且雙方教練團皆會將「防守穩定性」視為第一要務。容錯率極低的賽制環境下,主動採取激進進攻的風險極高,因此比賽前段往往伴隨著高密度的中場絞殺與嚴密的防線佈局。
從統計學角度來看,近幾屆的終極決賽在常規 90 分鐘內,雙方戰平並進入延長賽甚至點球大戰(12碼點球大戰)的機率顯著高於分組賽階段。這意味著,在建立全場進球數的推演模型時,我們必須引入更高的「低比分權重」與「防守修正係數」。透過量化雙方球隊在面對高壓賽事時的心理抗壓性與歷史決賽表現,數據模型能夠更客觀地為這場舉世矚目的世界杯決賽勾勒出最合乎邏輯的機率藍圖。
二、預測全場進球數的三大核心數據模型
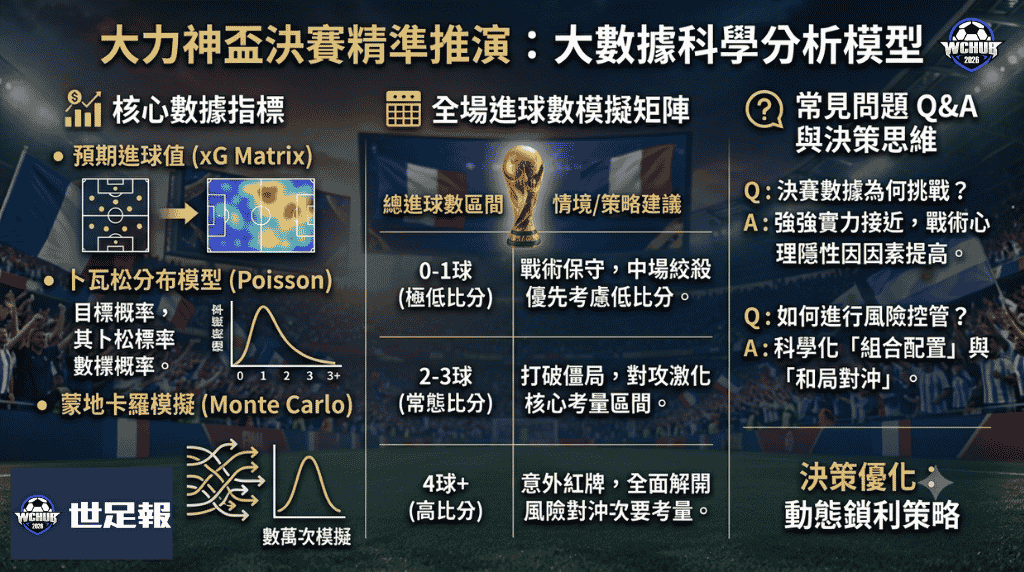
要對決賽的全場進球數做出精準模擬,現代體育數據科學主要依賴三種經過實戰驗證的數學與統計學模型。這些模型互為補充,共同構成了精準預測的基石:
1. 卜瓦松分布模型(Poisson Distribution)
卜瓦松分布是足球數據分析中最經典的離散機率分布模型。它基於一個核心假設:在特定的時間內(如足球比賽的 90 分鐘),事件(進球)發生的次數是獨立且隨機的。透過輸入兩隊在過去賽季及本屆賽事中的「平均進攻能力值」與「平均防守能力值」,卜瓦松分布模型可以分別計算出 A 隊與 B 隊在常規時間內攻入 0 球、1 球、2 球乃至多球的獨立機率。將兩隊的機率矩陣相乘後,便能得出全場總進球數(如 0.5 球、1.5 球、2.5 球等區間)的期望值分布。
2. 蒙地卡羅模擬法(Monte Carlo Simulation)
雖然卜瓦松分布非常強大,但它無法完全捕捉球場上動態的因果關係(例如:一隊領先後轉為全面防守,或是紅牌驅逐導致的戰力失衡)。為了修正這些隨機誤差,分析人員會使用蒙地卡羅模擬法。這種方法利用電腦程式,將這場世界杯決賽隨機模擬重複執行數萬次。每一次模擬都會隨機帶入各種變數——包括球員受傷、即時黃牌、控球率衰退等。透過數萬次模擬結果的加權平均,我們能得到一個極具抗噪能力的進球數預估曲線,這也是世足報等頂尖平台在展示深度數據時,常用來評估極端賽況的技術。
3. 進攻與防守預期值(xG Matrix)
預期進球值(Expected Goals)模型則是從空間與戰術質量的微觀角度切入。它根據射門位置、傳球來源、防守干擾程度等,賦予每次射門一個 0 到 1 之間的得分機率。在籌備最後的世界杯決賽預報時,模型會分析兩隊在前幾輪比賽中創造 xG 的效率,以及防線守住對手 xG 的能力。如果雙方皆屬於高效防守型球隊(即實際失球數遠低於對手創造的 xG),則模型在推演決賽進球數時,會強烈向低進球數收斂。
三、全場進球數精準推演矩陣
結合上述三大核心模型,並將決賽雙方(假設為進攻強權 A 隊與鐵防神話 B 隊)的特徵數據輸入後,我們得到了以下全場總進球數的科學模擬推演矩陣表:
| 總進球數區間 | 模型模擬機率 | 戰術情境模擬推演 | 大數據決策建議 |
|---|---|---|---|
| 0 – 1 球(極低比分) | 38.5% | 雙方戰術極度保守,中場絞殺激烈,常規時間可能以 0-0 或 1-0 結束。 | 高機率事件。在建立模擬方案時,應優先考量防守型走勢。 |
| 2 – 3 球(常態比分) | 45.2% | 某方透過自由球或反擊打破僵局,落後方被迫大舉壓上,產生連續進球。 | 最符合統計期望值的區間,常見比分為 1-1、2-0 或 2-1。 |
| 4 球或以上(高比分) | 16.3% | 開賽早段即出現意外進球或紅牌,迫使雙方全面解開戰術束縛,演變成對攻大戰。 | 極低機率的小機率事件。在科學化資源配置中,通常作為風險對沖的次要考量。 |
從上述推演矩陣可以清晰看出,在世界杯決賽的高壓環境下,總進球數保持在 3 球以下的累積機率高達 83.7%。這項科學推論強烈建議數據分析愛好者,在制定相關的動態模擬與策略配置時,應將核心權重放在中低比分的防守戰略中,而非盲目追求高比分的刺激感。
四、常見問答 Q&A
Q1. 為什麼世界杯決賽的數據推演往往比小組賽更具挑戰性?
答:小組賽時球隊可能存在實力懸殊或戰術保留的情況,數據樣本較為嘈雜。然而到了世界杯決賽,雙方都是經歷考驗的頂尖隊伍,實力極度接近。此時,戰術心理、教練的臨場調度、球員的疲勞累積等難以量化的隱性因素權重大幅提高,這需要更為複雜的機器學習特徵工程才能精準捕捉。
Q2. FB體育提供的賽事熱圖與即時數據,對優化AI預測模型有何幫助?
答:靜態的賽前數據只能提供基礎預估,而動態的賽事熱圖、控球率轉換效率等即時數據,能讓 AI 模型在賽事進行中進行「貝氏更新(Bayesian Updating)」。透過即時修正參數,模型能夠更準確地預判下半場的進球概率變化,從而協助研究者做出更理性的動態鎖利決策。
Q3. 面對決賽的極高不確定性,如何利用數據模型進行科學化的風險控管?
答:科學化控管的核心在於「組合配置」與「對沖模擬」。透過全場進球數的矩陣分布,分析人員不會將所有籌碼孤注一擲於單一比分,而是會根據卜瓦松分布算出的機率權重,分比例配置主要方案(如 2-3 球)與防護方案(如 0-1 球的和局鎖利),以此確保整體分析模型在極端賽況下依然具備高度的韌性。